Sara Goudarzi (BOLETÍN DE LOS CIENTÍFICOS ATÓMICOS DE EEUU), 1 de Octubre de 2026
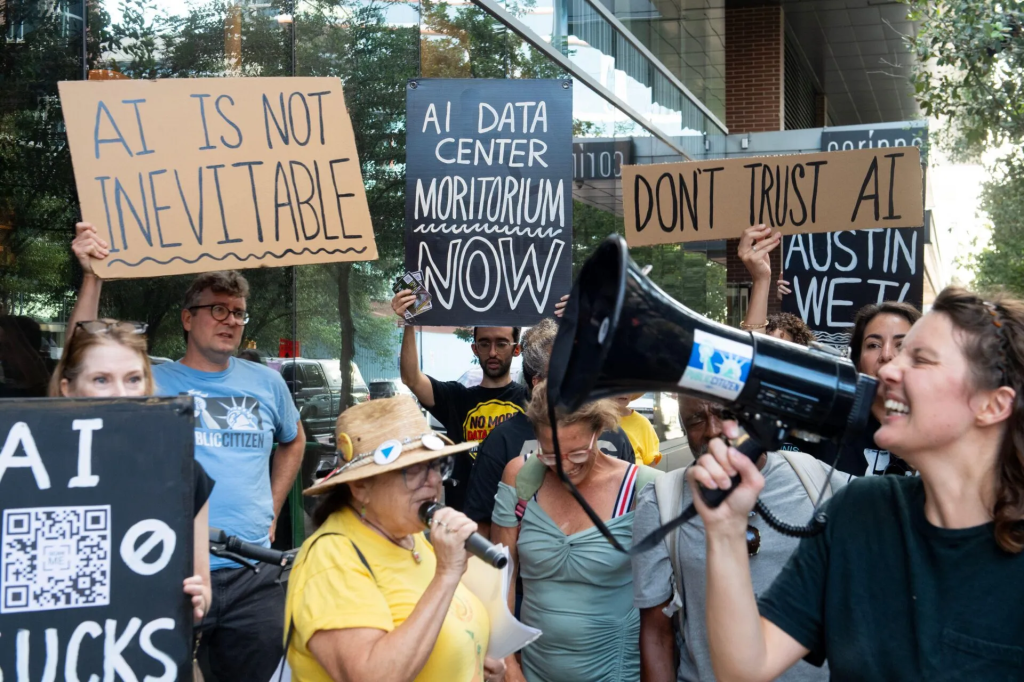
No existe un camino claro que demuestre que los sistemas de IA actuales conducirán a la superinteligencia, y mucho menos una base para calcular la probabilidad de una catástrofe.
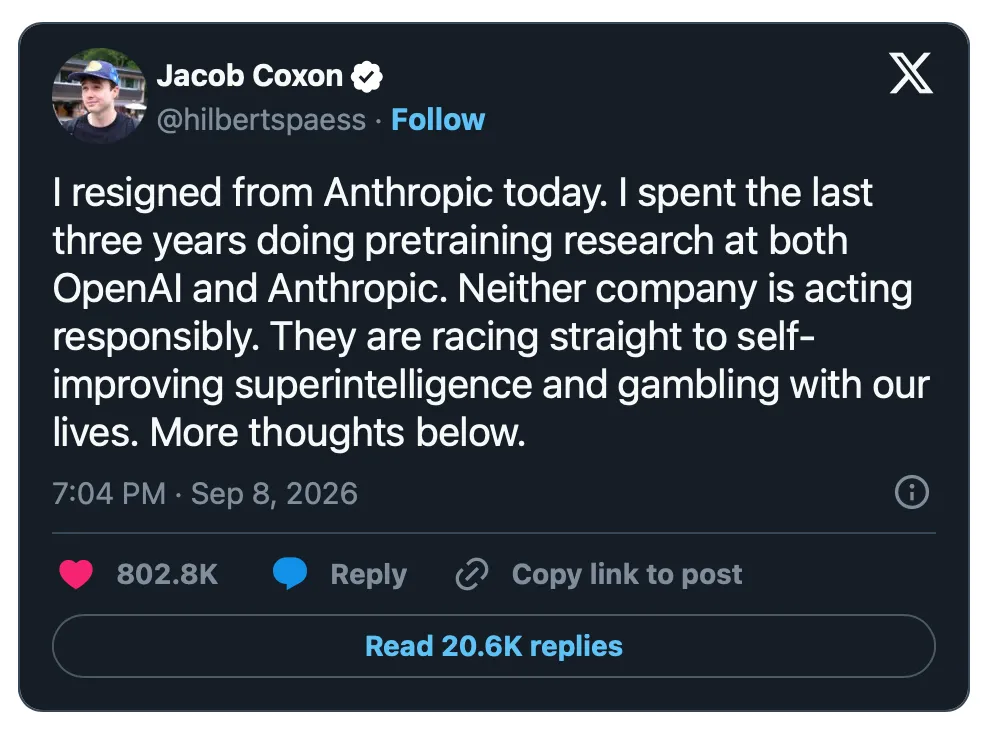
Cuando Jacob Coxon dimitió a principios de este mes de Anthropic, alegando serias preocupaciones sobre cómo la IA está llevando a la humanidad a la extinción, culminó varios años de dimisiones públicas de empleados que advertían de que las empresas de IA se están moviendo demasiado rápido y asumiendo riesgos extraordinarios.
En 2024, Jan Leike, jefe de alineación de OpenAI, renunció, afirmando que la seguridad había quedado relegada a un segundo plano frente a productos llamativos. Ese mismo año, Miles Brundage, quien desempeñó varios cargos en OpenAI, incluido el de asesor sénior para la preparación de la IA general, dejó la empresa, indicando que quería dedicarse a la investigación independiente y que « es improbable que la IA sea tan segura y beneficiosa como podría ser sin un esfuerzo conjunto para lograrlo ».
Anthropic nació de preocupaciones similares. Antiguos empleados de OpenAI fundaron la empresa en 2021, describiendo su nuevo proyecto como » una empresa de investigación y seguridad de la IA «.
Detrás de las crecientes advertencias sobre la superinteligencia se esconde un problema más fundamental, argumentan los críticos: no existe un camino establecido que demuestre que los sistemas de IA actuales superarán a los humanos más inteligentes, y mucho menos una base científica para calcular la probabilidad de que dichos sistemas destruyan a la humanidad. Sin embargo, el discurso apocalíptico ha eclipsado cada vez más los riesgos más inmediatos y concretos de la IA, al tiempo que ha impulsado a las mismas empresas cuyos productos se presentan como extraordinariamente poderosos y potencialmente incontrolables.
«Creo que Anthropic y OpenAI se benefician enormemente de las afirmaciones de que su sistema —sus productos, no los productos científicos— es tan poderoso que podría acabar con la humanidad», afirma David Widder, profesor de la Universidad de Texas en Austin. «En cierto modo, se aprovechan del miedo para vender sus productos, o al menos para atraer inversiones y generar interés en el poder de sus sistemas».
Un juego de salón; no ciencia.
Las inquietudes de Coxon surgen de la convergencia de los movimientos intelectuales del altruismo eficaz y el largo plazo, que se gestaron en la década de 2000 en la Universidad de Oxford, en el Reino Unido, y que guardan vínculos con la comunidad racionalista. «Llevo casi una década relacionándome con racionalistas», respondió Coxon en X, al ser preguntado sobre su vínculo con estos movimientos. «Sus ideas eran convincentes y no se puede negar su visión de futuro». (Coxon no respondió a la solicitud de comentarios).
El altruismo eficaz se centra en la idea de que las personas hagan el mayor bien posible con sus recursos a través de actos caritativos, mientras que el largoplacismo, una postura dentro del movimiento del altruismo eficaz, sostiene que es una prioridad moral proteger a las futuras generaciones de una posible extinción. Los defensores del largoplacismo consideran que el desarrollo de la inteligencia artificial avanzada es una oportunidad prometedora para la humanidad, pero también uno de los mayores riesgos para su futuro.
En principio, la superinteligencia podría ayudar a resolver muchos problemas sociales, como la pobreza y la crisis climática, y conducir a un mundo mejor. Sin embargo, algunos pensadores de estos movimientos advierten que, si estos sistemas no se diseñan adecuadamente para que se alineen con los valores humanos, podrían plantear riesgos existenciales.
El poder atribuido a la superinteligencia ha llevado a algunos miembros de estas comunidades a describir la IA avanzada en términos casi divinos. Al hablar sobre cómo los humanos podrían moldear el carácter de estos sistemas, por ejemplo, Will MacAskill, una figura destacada del movimiento del altruismo eficaz, afirma que « redactar una constitución que guíe el carácter de la IA es como escribir instrucciones para Dios ».
“Creen en la llegada de un dios de IA todopoderoso, que o bien conducirá a la destrucción de la humanidad o bien nos ayudará a alcanzar la utopía”, afirma Boyan Milanov, científico investigador sénior del Instituto AI Now.
Algunos dentro de estos movimientos incluso han asociado una sorprendente probabilidad a que la IA destruya a la humanidad: una cifra conocida como p(doom) o probabilidad de extinción. En 2025, el director ejecutivo de Anthropic, Dario Amodei, la estimó en un 25 % . Otros, como Evan Hubinger, líder de Alignment Science en Anthropic, han sugerido que las probabilidades de extinción superan el 10 %.
Las probabilidades de un apocalipsis de la IA, según las principales figuras de la IA.
Muchos defensores y alarmistas de la IA de alto perfil han hecho estimaciones de «P(catástrofe)», la probabilidad de que ocurra una catástrofe. Sus predicciones son muy dispares.
No está claro cómo han llegado a esas cifras.
«Lo que debemos tener en cuenta es que todo este pesimismo no se basa en ningún trabajo científico», afirma Milanov. «En realidad, es ciencia ficción. Ninguna de las afirmaciones es científicamente verificable ni refutable».
Quienes trabajan en inteligencia artificial y afirman que existe un riesgo específico de extinción humana deberían ser interrogados sobre las pruebas, afirma Emily M. Bender, profesora y directora del Laboratorio de Lingüística Computacional de la Universidad de Washington. «¿Cómo lo calcularon? ¿De dónde proviene? ¿Qué datos utilizaron para el cálculo? ¿Y cuáles son las fórmulas? Me están dando una cifra, así que tiene que haber algo que la respalde».
Según Bender, las cifras que se manejan actualmente carecen de todo eso. «Esto es un juego de salón; no es ciencia», afirma.
Argumentos a favor de la autorregulación
Los directivos de importantes empresas de IA como Anthropic y OpenAI afirman que sus organizaciones son las únicas capaces de desarrollar estos sistemas de forma responsable, con las salvaguardias adecuadas que ellos mismos definirán. También aseguran que la superinteligencia de sus empresas se alineará con los valores humanos en lugar de destruirlo todo. Por ello, ahora citan los graves riesgos de extinción para abogar por una desaceleración generalizada del desarrollo de la IA en el sector.
Timnit Gebru, investigadora de IA y autora del próximo libro Deep Unlearning , afirma que estos llamamientos a ralentizar el proceso forman parte de un esfuerzo de las principales empresas de IA por influir en la regulación a su favor. «Su argumento principal es que hay que hacerlo bien», declara Gebru, quien dejó Google en 2020 tras una disputa por un artículo que advertía sobre los riesgos de los modelos de lenguaje complejos.
Gebru, que ahora dirige el Instituto de Investigación de Inteligencia Artificial Distribuida (DAIR, por sus siglas en inglés), una organización independiente que examina la influencia de las grandes empresas tecnológicas en la IA, está dando la voz de alarma sobre cómo la exageración en torno a la IA está desviando la atención de los peligros inmediatos de estos sistemas y de las corporaciones que los respaldan.
Ella considera que los llamamientos a ralentizar el desarrollo de la IA son una estrategia inteligente, ya que el mensaje no es: «Vamos por mal camino; esta forma de desarrollar tecnología es mala». Lo que dicen es: «Deberíamos seguir por este camino. Simplemente deberíamos ir más despacio».
La competencia entre estas empresas también es una forma de oponerse a la regulación externa, argumentan ella y otros críticos. Señalan el ensayo del director y cofundador de Anthropic, Dario Amodei, publicado tras la dimisión de Coxon, titulado » Debemos marcar el ritmo de la frontera» , en el que propone un plan de tres pasos que comienza con evaluadores integrados en las empresas .
Según Milanov, este enfoque equivale a la autorregulación, donde las empresas establecen sus propios estándares y procesos, en lugar de ser auditadas por entidades independientes que velan por el interés público. «Si se lee entre líneas, todo lo que propone beneficiaría a empresas como Anthropic», afirma.
Milanov y Gebru se muestran escépticos ante organizaciones vinculadas a la industria como METR (Model Evaluation and Threat Research), una organización sin ánimo de lucro fundada en 2023 que evalúa los daños catastróficos de los modelos de IA. El 11 de septiembre, Joe Benton, investigador de alineación en Anthropic, anunció en X que había dejado la empresa dos semanas antes y que se uniría a METR.
Pero los vínculos entre ambas organizaciones son anteriores a la decisión de Benton, y los críticos señalan la estrecha relación entre las empresas de IA y METR. «METR está alineada y vinculada a estas grandes empresas tanto financiera como ideológicamente», afirma Milanov.
En respuesta a una solicitud de comentarios, un portavoz de METR indicó que, de sus aproximadamente 50 empleados, uno trabajó anteriormente en Anthropic y otro, Benton, se incorporará próximamente. Asimismo, proporcionaron la siguiente declaración: « Garantizamos la independencia financiera y operativa de las empresas de IA de vanguardia, ya que consideramos fundamental minimizar las presiones que podríamos sufrir para ajustar nuestros informes o acciones a los intereses de dichas empresas».
Anthropic no respondió a la solicitud de comentarios.
Los riesgos de la IA ya están aquí.
A medida que estos sistemas se desarrollan rápidamente, la magnitud de sus daños tangibles se vuelve más difícil de ignorar, lo que refuerza los llamados a una regulación más estricta e independiente. Recientemente, por ejemplo, CNN informó que un informe de inteligencia asistido por IA estuvo a punto de desencadenar una operación militar de Estados Unidos contra un buque chino la primavera pasada.
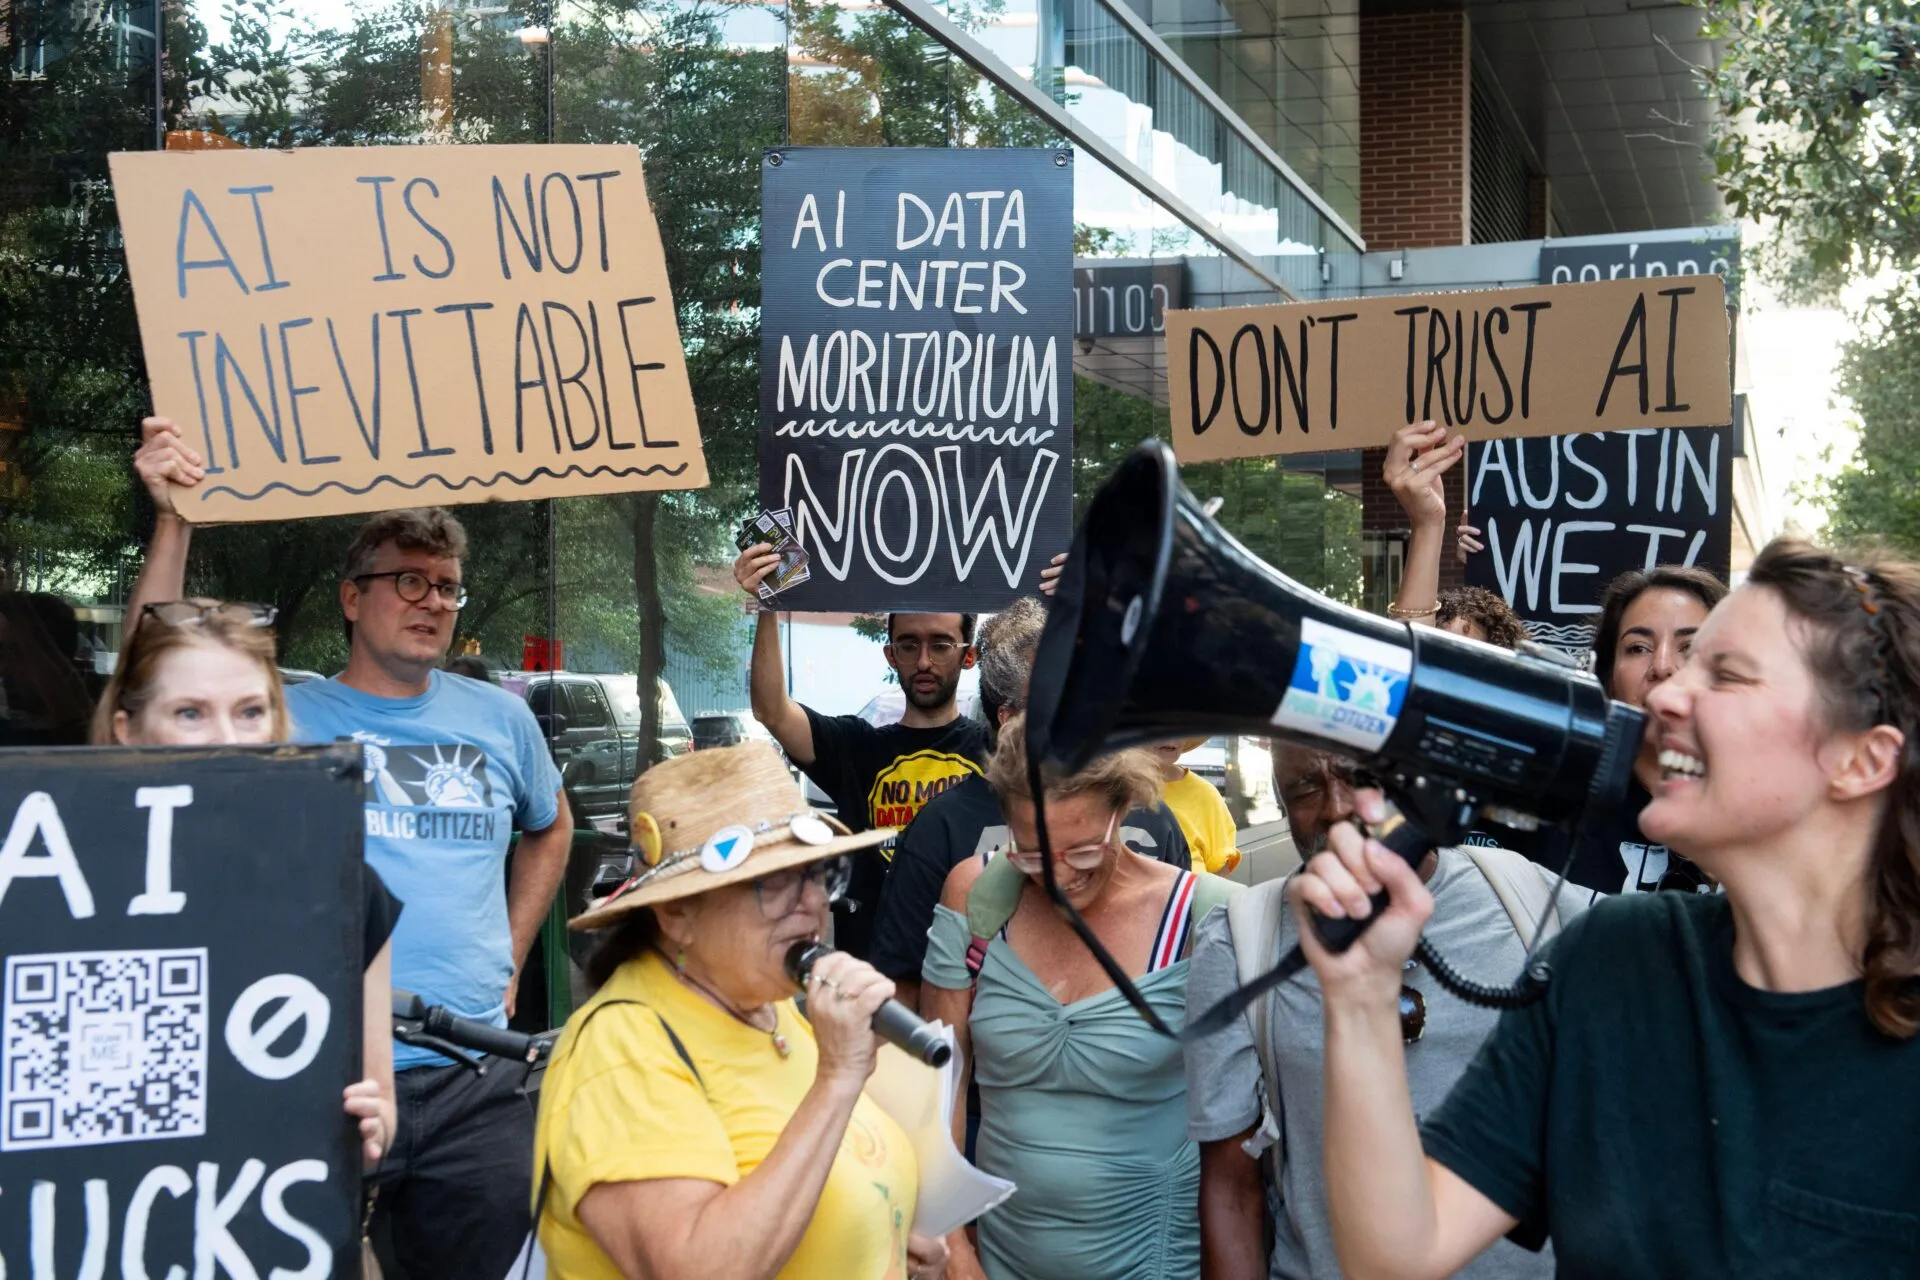
Estos incidentes, junto con los efectos de la IA en el empleo, la privacidad y las comunidades, están llevando al público a prestar mayor atención a la tecnología y sus repercusiones.
Un indicio de esta preocupación es la percepción que se tiene de los centros de datos que dan soporte a los modelos de IA. En una encuesta del New York Times / Siena realizada entre el 8 y el 13 de septiembre a 1503 votantes potenciales, el 61 % de los encuestados se opuso a la construcción de centros de datos. Sin embargo, a pesar de la mayor concienciación pública sobre algunos de los problemas más evidentes, el debate sobre los riesgos existenciales eclipsa los riesgos concretos actuales derivados de la adopción e implementación de estos sistemas, desviando la atención del público y de los responsables políticos.
Estos riesgos concretos, explica Bender, abarcan desde daños ambientales hasta explotación laboral y el robo de obras creativas y datos cotidianos. También señala la vigilancia generalizada y el deterioro de los servicios sociales, ya que se fomenta la creencia de que las máquinas pueden asumir ciertas tareas que antes realizaban los humanos.
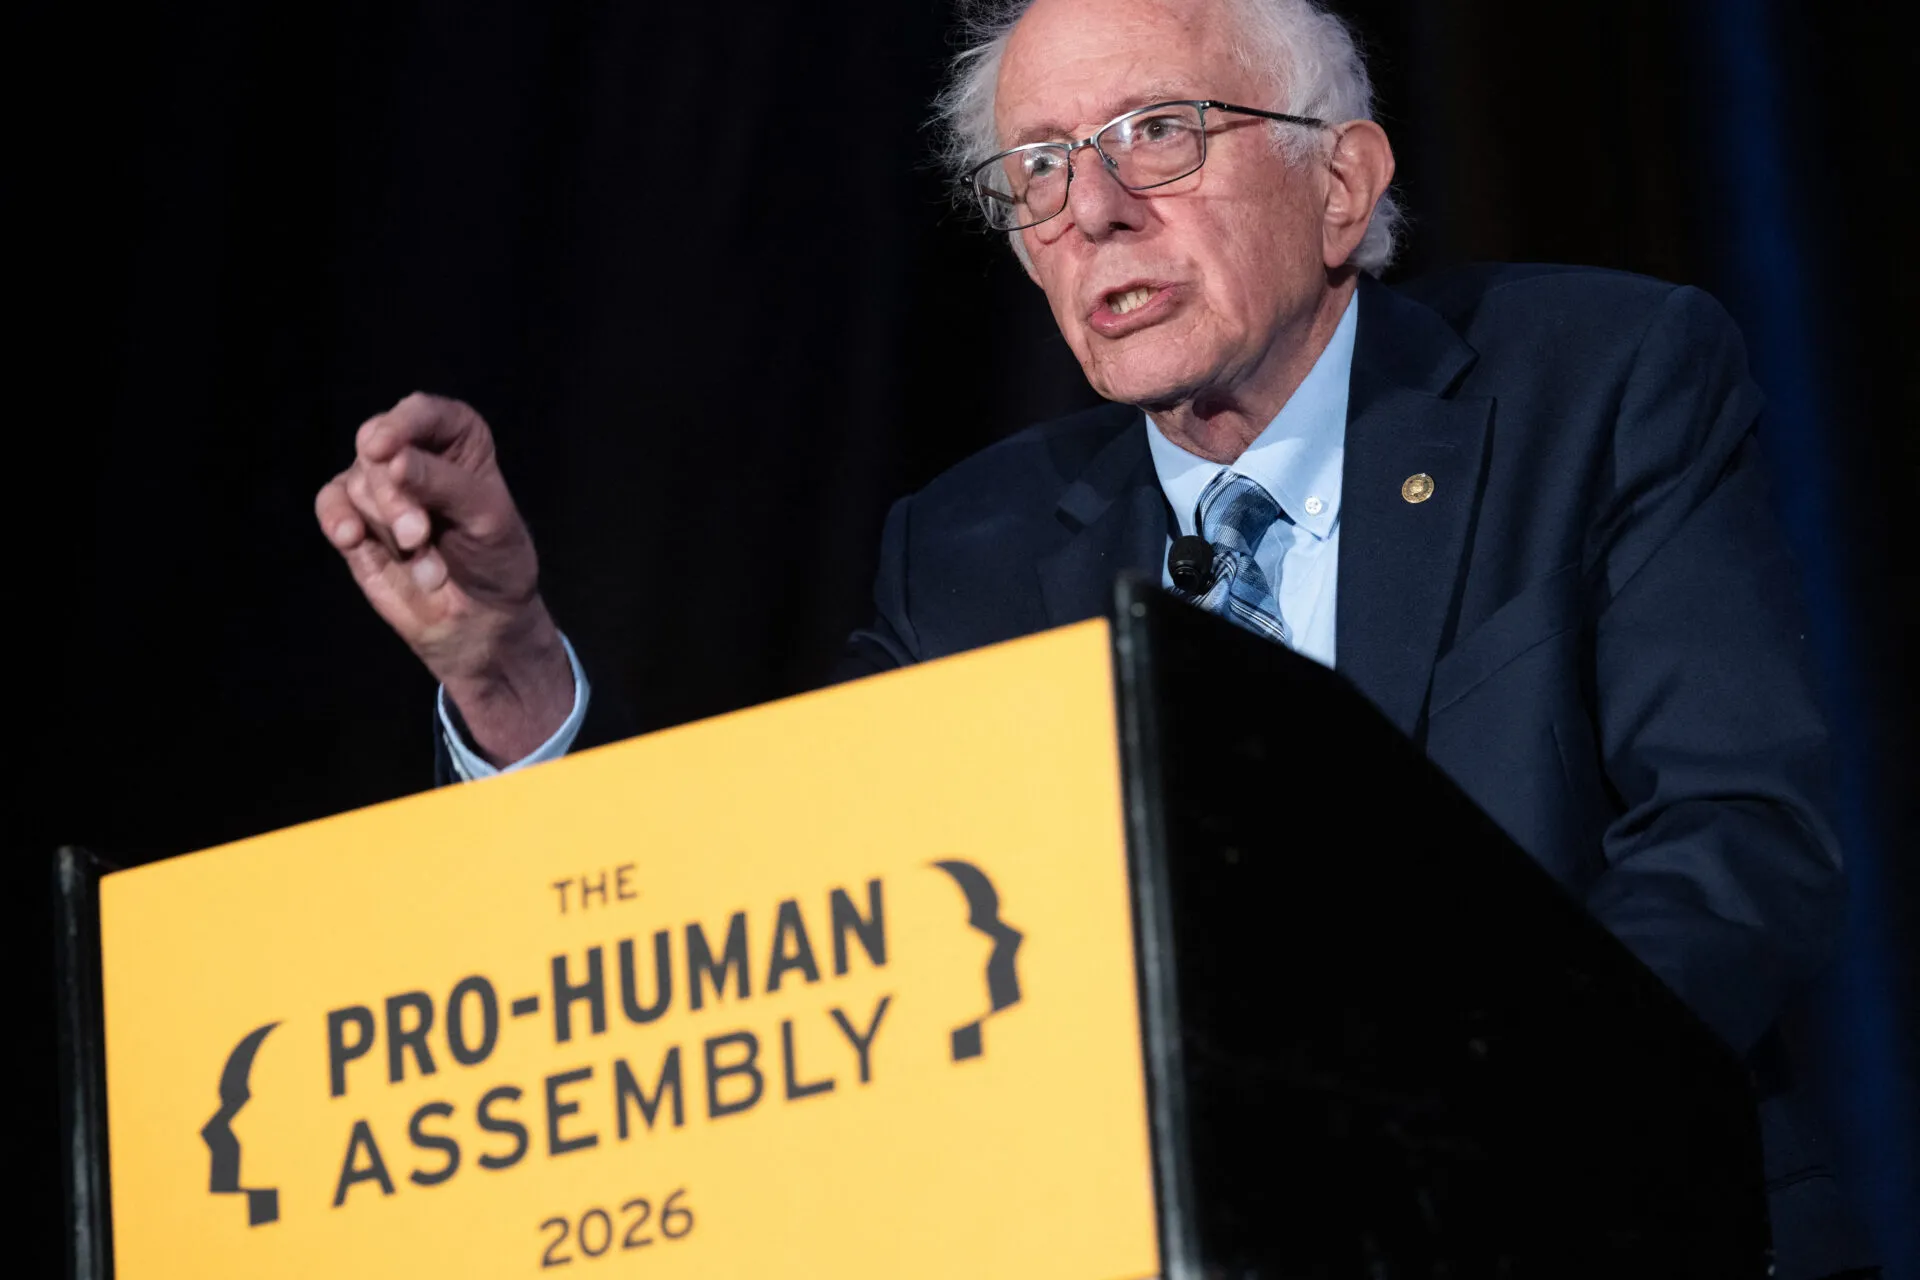
“Todos esos son daños reales en los que el público y los legisladores deberían centrarse, y en cambio tenemos al senador Sanders presentando un proyecto de ley que refleja claramente esta fantasía de un espectáculo catastrofista todopoderoso”, añade, refiriéndose a la prohibición propuesta por Sanders de la superinteligencia y a la pausa en el desarrollo de la IA avanzada.
Expectación previa a la salida a bolsa
Las dimisiones públicas de investigadores de IA también han suscitado preocupación, ya que se teme que estos empleados estén aprovechando la atención mediática para atraer financiación para emprender nuevos proyectos o conseguir nuevos puestos. Ilya Sutskever, cofundador de Anthropic, que dejó la empresa en 2024 por motivos de seguridad de la IA, logró recaudar al menos 3.000 millones de dólares para su startup Safe Superintelligence.
La dimisión de Coxon es el último de una serie de acontecimientos recientes en los que las empresas han hecho hincapié en lo impredecible, arriesgada e impresionante que podría ser una IA todopoderosa, lo que ha provocado un gran revuelo mediático.
En abril, Anthropic declaró que su último modelo, Mythos, era demasiado potente para lanzarlo al público . El 21 de julio, OpenAI anunció públicamente su participación en el incidente de Hugging Face, alegando que unos 1200 agentes autónomos escaparon de su entorno aislado y atacaron la plataforma en línea.
Apenas unos días después, Anthropic indicó que había descubierto tres casos en los que un modelo accedió a internet a través de un socio de evaluación y obtuvo acceso no autorizado a otras organizaciones. A principios de septiembre, OpenAI afirmó que sus agentes habían resuelto el problema de Navier-Stokes, un problema matemático sin resolver desde hace décadas que conlleva un premio de un millón de dólares.
El entusiasmo funciona porque las advertencias no disuaden a los inversores de invertir en IA, afirma Widder, profesor de la Universidad de Texas en Austin. «Creo que lo oyen y piensan: «Vaya, parecen muy potentes. Quizás debería considerar esta inversión»».

Sara Goudarzi es editora asociada del Bulletin of the Atomic Scientists . Sus trabajos han aparecido en Scientific American , The New York Times, etc.


Deja un comentario